
Deepslate sichert sich 7,7 Millionen Euro für europäische Sprach-KI
Das Berliner Model Lab trainiert eigene Speech-to-Speech-Modelle und hostet in Deutschland. Laut Artificial Analysis ist es das weltweit schnellste Modell seiner Art.
Berlin, 01.10.26 – Deepslate, ein Berliner AI Model Lab für Sprach-KI, hat eine Seed-Finanzierungsrunde über 7,7 Millionen Euro abgeschlossen. Angeführt wird die Runde vom Münchener Technologie-Investor 42CAP. Weitere Investoren sind Alstin Capital, Bestandsinvestor SIVentures sowie mehrere Business Angels. Deepslate trainiert eigene Speech-to-Speech-Modelle. Sie verarbeiten gesprochene Sprache direkt, ohne Umweg über Text. In der unabhängigen Vergleichsmessung von Artificial Analysis ist Deepslate das weltweit schnellste Speech-to-Speech-Modell (Stand September 2026). Versicherer, Contact Center und Plattformen setzen die Technologie bereits produktiv ein. Mit dem Kapital baut das 15-köpfige Team Modelltraining, Vertrieb und die europäische Infrastruktur aus.
Ein Model Lab, kein Telefonie-Produkt
Der Markt für Sprach-KI besteht überwiegend aus Plattformen und Integratoren, die fremde Modelle über eine API verpacken. Deepslate trainiert eigene Modelle. In Europa gibt es nur eine Handvoll Unternehmen, die das tun. KI-Technologie beziehen europäische Unternehmen bisher meist aus den USA. Latenz, Verständnis für europäische Sprachen und Datensicherheit sind dabei nicht verhandelbar. Deepslate hat ein Voice-AI-Modell mit Schwerpunkt auf europäischen Sprachen entwickelt, das vollständig in der EU gehostet wird.
Wie Deepslate entstand: drei Sekunden waren zu lang
2023 gründeten Paskal Paesler und Jan Brachthäuser in Berlin ihr erstes gemeinsames Unternehmen: Unter Anderem in dem Produkt war ein KI-Assistent, der in Meetings mithört und Fragen mit Unternehmenswissen beantwortet. Der Assistent scheiterte an der Sprach-KI seiner Zeit. Bis ein Sprachagent antwortete, vergingen rund drei Sekunden. Ein natürliches Gespräch war damit unmöglich. Der Grund lag in der Architektur. Herkömmliche Sprach-KI arbeitet in drei Stufen:
Gesprochenes wird in Text umgewandelt, von einem Sprachmodell verarbeitet und wieder in Sprache übersetzt. Jede Konvertierung kostet Zeit. Tonfall, Betonung, Ironie und Dialekt gehen unterwegs verloren. Die Gründer lasen monatelang Forschungsarbeiten und Open-Source-Projekte zu einem damals kaum beachteten Ansatz und beschlossen, das Modell selbst zu bauen. Aus den Recherchen wurde Deepslate.
Für europäische Unternehmen kommt ein zweites Problem hinzu. Modelle, die überwiegend auf US-Englisch trainiert wurden, scheitern regelmäßig an deutschen Namen, Straßenadressen und Dialekten. In regulierten Branchen wie Versicherung oder Banking hat ein falsch verstandener Name oder eine vertauschte Hausnummer teure Folgen.
Audio rein, Audio raus
Deepslate ersetzt die dreistufige Kette durch ein einziges durchgehendes Modell. Audio geht hinein, Audio kommt heraus. Semantik und Prosodie liest das Modell direkt aus dem Klang, ohne verlustbehaftete Textzwischenstufe. Technisch besteht das System aus drei selbst trainierten Komponenten: einem Speech Encoder, der die Audio-Wellenform in einen semantisch-prosodischen Vektorraum abbildet, einem Reasoning Core auf Basis eines Open-Weights-Frontier-Sprachmodells, das Deepslate sprachspezifisch nachtrainiert, und einem Speech Decoder, der Audio mit kontrollierter Prosodie und natürlichem Turn-Taking direkt aus den Reasoning-Embeddings erzeugt.
Der Kern der Architektur ist die Entkopplung. Encoder und Decoder hängen über trainierbare Projektoren an einem austauschbaren Sprachmodell. Kommt eine neue Sprachmodell-Generation, trainiert Deepslate nur die Projektoren neu. Ein Trainingslauf kostet dann Tage statt Monate und einen Bruchteil der Rechenzeit, die das gemeinsame Vortraining eines Omni-Modells verlangt.
Messwerte: Tempo ohne Verlust an Denkleistung
Sprach-KI steht vor einem Zielkonflikt. Modelle, die im Gespräch komplex schlussfolgern, werden langsam. Modelle, die schnell antworten, bleiben oberflächlich. Deepslate löst diesen Konflikt anders als die großen US-Anbieter.
- Geschwindigkeit: 440 Millisekunden in der unabhängigen Messung von Artificial Analysis, der schnellste Wert im Feld (Stand September 2026). In der eigenen Messung, vom Ende der Nutzeräußerung bis zur ersten Silbe der Antwort und ohne Netzlaufzeit über weite Strecken, liegt der Wert bei 250 Millisekunden.
- Sprachverständnis (BIG-Bench Audio): rund 85 Prozent Genauigkeit bei dieser Antwortzeit. Wettbewerbsmodelle kommen höher, aber nur in Betriebsmodi, deren Antwortzeit für ein natürliches Telefongespräch nicht mehr taugt.
- Europäische Sprachen (CoVoST2): beste Fehlerrate im Vergleichsfeld.
Die Messmethodik ist öffentlich dokumentiert: github.com/deepslate-labs/deepslate-benchmarks
Zwei Cent pro Minute
Die effiziente Architektur schlägt sich im Preis nieder. Deepslate bietet sein Modell über eine Self-Service-Plattform mit API für bis zu 2 Cent pro Gesprächsminute an. Vergleichbare Echtzeitmodelle aus den USA kosten je nach Nutzung zwischen 6 und 15 Cent pro Minute. Entwickler und Start-ups können das Modell damit ohne Vertragsgespräch einsetzen. Für Plattformanbieter und Enterprise-Kunden gibt es Volumen- und Self-Hosting-Modelle.
Souveränität, die geprüft werden kann
Versicherer, Banken, Kliniken und Behörden dürfen Kundendaten häufig nicht an US-Cloud-Anbieter übermitteln. Deepslate betreibt seine Modelle in der Telekom Cloud in Deutschland. Alternativ läuft das Modell vollständig in der Infrastruktur des Kunden, auf Wunsch ohne Verbindung nach außen. In dieser Variante hat auch Deepslate selbst keinen Zugriff auf die Daten. Das Unternehmen ist nach ISO 27001 zertifiziert. Auftragsverarbeitungsvertrag, Subprozessorenliste und Hosting-Region liegen offen zur Prüfung.
„Datensouveränität ist für unsere Kunden kein Nice-to-have, sondern Voraussetzung“, sagt Paesler. „Und sie ist prüfbar oder sie ist nichts. Deshalb legen wir offen, wo gerechnet wird, wer Subprozessor ist und was noch offen ist.“
Wohin die Finanzierung fließt
- Modell und Trainingsdaten: Ausbau des europäischen Datenprogramms, besonders deutsche Straßen- und Personennamen sowie Dialekte. Dazu weniger Latenz und bessere Sprachqualität.
- Team und Go-to-Market: Die Nachfrage übersteigt derzeit die Kapazität im Vertrieb; die Runde finanziert den Aufbau von Sales- und Marketing-Teams.
- Infrastruktur: Ausbau der Produktionsumgebung für wachsende Anrufvolumina in europäischen Rechenzentren.
„Europa braucht eigene Sprachmodelle, und Deepslate ist eines der wenigen Teams hier, die ein eigenes Speech-to-Speech-Modell trainieren“, sagt Julian von Fischer, General Partner bei 42CAP. „Was uns an Paskal und Jan überzeugt hat, ist ihre technische Tiefe: Mit einem kleinen Team und einem Bruchteil der Rechenzeit großer Labore haben sie das schnellste Speech-to-Speech-Modell der Welt gebaut.“
„Paskal und Jan haben bereits vor Deepslate latenzkritische Systeme für Millionen Nutzer skaliert. Heute übertragen sie diese Erfahrung auf ein eigenes Speech-to-Speech-Modell, das natürliche Echtzeitgespräche datensicher und lokal auf der Infrastruktur des Kunden ermöglicht. Wir haben investiert, weil wir ein weltweit wettbewerbsfähiges Voice AI Model Lab sehen, das eine zentrale europäische Lösung für Voice AI aufbauen wird“, so Andreas Schenk, Partner bei Alstin Capital.
Ausblick: Sprache als Schnittstelle zur Maschine
Bei Bildern und Videos ist KI-generierter Inhalt inzwischen kaum noch von echten zu unterscheiden. Bei Sprache in Echtzeit ist das noch nicht der Fall. Genau diese Lücke schließt Deepslate. Der Kundenservice ist dabei nur der erste Markt. Langfristig sieht das Unternehmen Sprache als natürliche Schnittstelle zwischen Mensch und Maschine: in Fahrzeugen, in Geräten und in Robotern. Erste Kunden nutzen das Modell bereits als Sprachschnittstelle für ihre eigenen KI-Systeme.
Deepslate ist ein Berliner AI Model Lab, das eigene Sprach-KI entwickelt. Das Unternehmen trainiert ein Speech-to-Speech-Modell, das gesprochene Sprache direkt verarbeitet, ohne sie zunächst in Text umzuwandeln.
Deepslate hat eine Seed-Finanzierungsrunde über 7,7 Millionen Euro abgeschlossen. Angeführt wird die Runde von 42CAP, weitere Investoren sind Alstin Capital, SIVentures sowie mehrere Business Angels.
Das Speech-to-Speech-Modell verarbeitet Audio direkt und soll dadurch besonders schnelle und natürliche Gespräche ermöglichen. Zudem liegt der Schwerpunkt auf europäischen Sprachen und einer europäischen Infrastruktur mit Hosting in Deutschland.
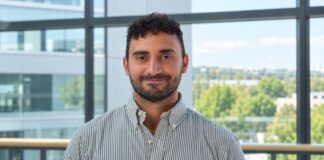
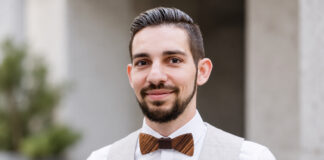
Deepslate Gründer Paskal Paesler und Jan Brachthäuser Bildcredits: Deepslate AI generated
Quelle Maschmeyer Group MM Support GmbH